

Das Ausführen eines lokalen Sprachmodells auf RK3588 beinhaltet das Modellformat, die Laufzeitunterstützung und den Speicher sowie den Prozessor. Eine kurze Textgenerierungsdemonstration ist ein Ausgangspunkt. Eine nützliche Auswertung misst auch die sofortige Handhabung, nachhaltige Ausgabe und Speichernutzung.
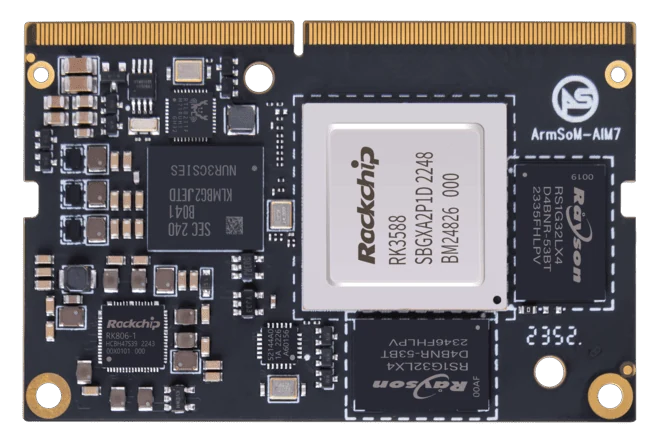
ArmSoM AIM7
Wählen Sie ein Modell, das die Software tatsächlich laden kann
Überprüfen Sie die unterstützte Modellarchitektur, Quantisierung und Laufzeitversion, bevor Sie große Gewichte herunterladen. Geben Sie die Modellkennung und die Umwandlungsschritte auf. Messen Sie die Inbetriebnahme, die zeitnahe Verarbeitung und Generierung separat mit repräsentativen Eingabelängen. Halten Sie den Tokenizer und die Modellkonfiguration zusammen, damit eine spätere Änderung von einem Hardwareunterschied unterschieden werden kann.
Budget mehr als Gewichte
Modellgewichte sind nur ein Teil der Gedächtnisnutzung. Kontextzustand, temporäre Puffer, das Betriebssystem und andere Dienste benötigen ebenfalls Platz. Längere Aufforderungen und mehrere Sitzungen können den Spitzenverbrauch verändern. Wählen Sie eine Speicherkonfiguration basierend auf der vollständigen Anwendung und Reserve-Headroom, anstatt alle angekündigten RAM als für das Modell verfügbar zu behandeln.
Messen Sie die Erfahrung, die Benutzer bemerken werden
Die Länge der Eingabeaufforderung, die Ausgabelänge, die Quantisierung, die Kontextgrenze und die Kühlung sind aufzuzeichnen. Messen Sie die Zeit bis zum ersten Token getrennt von der Erzeugungsrate und wiederholen Sie den tatsächlichen Abruf- oder Werkzeugworkflow. Prüfen Sie die Outputqualität nach der Konvertierung. Eine schnelle kurze Demonstration sollte nicht als nachhaltige Leistung für jedes Modell oder jede Kontextgröße beworben werden.

ArmSoM Sige7
Passen Sie die Wahl an Ihre Anforderungen an
Anforderung oder Situation | Was zu bewerten ist | Einzelheiten der Entscheidung |
Modellkompatibilität | Architektur und Exportpfad | Bestätigen Sie mit dem aktuellen Toolkit. |
Arbeitsspeicher | Gewichte plus Kontext und Dienstleistungen | Spitzenverbrauch messen. |
Wechselwirkung | Erste Token und nachhaltige Generation | Aufforderungen des Prüfvertreters. |
Beispielhafte Gestaltung
Messen Sie eine interaktive Sprachmodell-Workload
Eine chat-anwendung benötigt mehr als eine einzelne token-pro-sekunde-nummer. Definieren Sie eine realistische prompte, erwartete Antwortlänge, Kontextgröße und Parallelität. Messen Sie die Wartezeit vor der ersten Nutzausgabe getrennt von der nachfolgenden Generation. Fügen Sie Modelllade- und Speicherdruck hinzu, wenn die Anwendung Modelle wechselt. Eine Demonstration mit einer kurzen Aufforderung kann nicht die Erfahrung einer längeren Dokumentanalysesitzung nachweisen. Ohne einen reproduzierbaren Durchlauf wird hier kein Durchsatzergebnis beansprucht.
Hardware und Dokumentation
Sige7 · RK3588
RK3588, 6 TOPS NPU, dual 2.5GbE und M.2 PCIe 3.0 x4. Überprüfen Sie die ausgewählte eMMC und die drahtlose Konfiguration.
Hardware-Dokumentation · Produktdetails
AIM7 · RK3588
RK3588-Modul mit einem 6 TOPS NPU und 260-pin SO-DIMM-Anschluss. ArmSoM hat einen Jetson Nano B01-Träger getestet; Dies stellt keine Kompatibilität mit allen Jetson-Carriern oder NVIDIA-Software her.
Hardware-Dokumentation · Produktdetails
Häufig gestellte Fragen
Kann ich eine Tokenrate aus den RK3588-Spezifikationen versprechen?
Nein. Es benötigt ein benanntes Modell, Laufzeit, Kontext und reproduzierbare Messung.
Garantiert ein größerer RAM eine schnellere Antwort?
Es kann den Speicherdruck verhindern, aber Berechnung, Speicherbandbreite und Laufzeitverhalten bestimmen immer noch die Geschwindigkeit.
Produktinformationen und Support
Quellen
Geschrieben von ArmSoM mit der folgenden Dokumentation. Beispieldesigns sind Vorschläge, keine gemessenen Kundeninstallationen.